
เวลาไปสอนในองค์กร คำถามที่ผมเจอบ่อยมากคือ เอกสารงานอย่างตัวเลขยอดขาย ข้อมูลพนักงาน หรือสัญญากับลูกค้า เราจะส่งขึ้น AI บนคลาวด์ได้แค่ไหน
ยังไม่นับค่าสมาชิกรายเดือน กับโควตาที่ชอบเต็มตอนกำลังใช้งานอยู่พอดี หลายคนเลยเริ่มได้ยินคำว่า Local AI หรือการเอา AI มาทำงานบนเครื่องของเราเอง แต่พอเปิดแอปขึ้นมาก็เจอศัพท์เต็มจอ ทั้ง 27B, Q4, VRAM จนไม่รู้จะเริ่มตรงไหน
ในคลิปนี้ผมเลยลองให้ดูกันจริง ๆ ครับ ถอดสาย LAN ปิด Wi-Fi แล้วให้ AI อ่านเอกสารงานทั้งโฟลเดอร์ สรุปเรื่องที่ผู้บริหารต้องตัดสินใจ แล้วต่อด้วยการเจนภาพและคลิปสั้น ทั้งหมดทำบนเครื่องเดียว โดยเครื่องที่ใช้ทดสอบ ASUS Thailand ส่งมาให้ลองครับ
บทความนี้สรุปมาจากคลิป YouTube ของผม อ่านจบแล้วจะได้ 3 อย่างครับ
- เข้าใจว่า Local AI ทำงานยังไง ผ่านภาพเปรียบเทียบเรื่องครัว จนอ่านหน้าจอแอปออก
- รู้วิธีเริ่มประเมินว่าคอมของเรารันโมเดลไหนได้ โดยดู VRAM และหน่วยความจำที่ต้องเผื่อ
- เห็นตัวอย่างงานจริง ทั้งงานเอกสารแบบไม่ต่อเน็ต และงานเจนภาพกับวิดีโอ พร้อม Prompt ที่ใช้ในคลิป
Local AI 101 · เอา AI มาไว้ในเครื่องเรา
เปิดดูบน YouTubeเมื่อกดเล่น จะโหลดวิดีโอจาก YouTube ตามนโยบายของผู้ให้บริการLocal AI คืออะไร เทียบกับครัวที่บ้าน
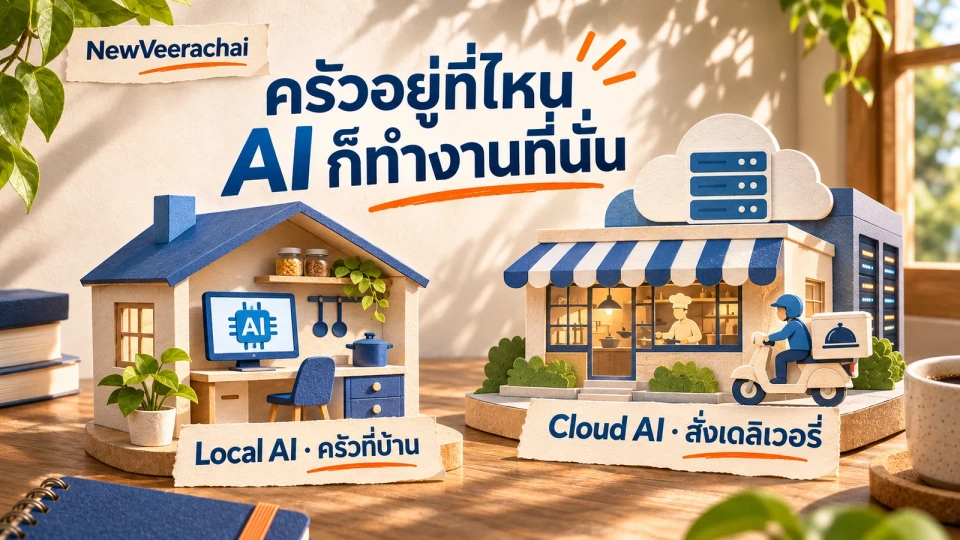
เวลาเราใช้ AI อย่าง ChatGPT ให้นึกภาพเหมือนสั่งอาหารเดลิเวอรี่ครับ เราสั่งผ่านแอป ออเดอร์วิ่งผ่านอินเทอร์เน็ตไปถึงครัวของร้าน ซึ่งก็คือศูนย์ข้อมูลของบริษัท AI พอครัวทำเสร็จก็ส่งกลับมา เราถึงเห็นคำตอบขึ้นบนจอ
ส่วน Local AI ก็คือการมีครัวอยู่ที่บ้าน เมนูเดิม แต่ทำในครัวของเราเอง ของไม่ต้องออกจากบ้าน ไม่ต้องรอไรเดอร์ แล้วก็ไม่มีค่าส่งทุกครั้งที่สั่ง
AI ทุกตัวมี 4 ชิ้นเหมือนกัน
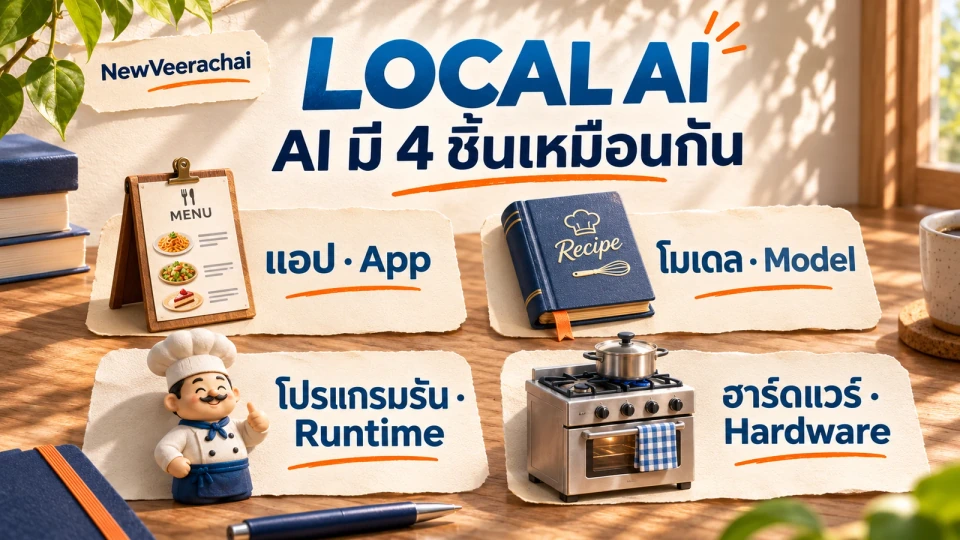
ไม่ว่าจะเป็นครัวที่ร้านหรือครัวที่บ้าน AI ทุกตัวประกอบด้วย 4 ชิ้นเหมือนกันครับ
| ชิ้นส่วน | เปรียบกับครัว | ทำหน้าที่อะไร |
|---|---|---|
| แอป | เมนูกับหน้าร้าน | ที่ที่เราพิมพ์สั่งงาน |
| โมเดล | สูตรอาหาร | ชุดความรู้ของ AI เป็นตัวตัดสินว่า AI จะเก่งหรือไม่เก่ง |
| โปรแกรมที่รันโมเดล | พ่อครัว | อ่านสูตรแล้วลงมือทำ |
| ฮาร์ดแวร์ | ครัวกับเตา | บอกว่าครัวเล็กหรือใหญ่แค่ไหน |
AI บนคลาวด์ ทั้ง 4 ชิ้นอยู่ที่บริษัทผู้ให้บริการหมด ส่วน Local AI เราโหลดสูตรกับพ่อครัวมาไว้ในเครื่อง แล้วใช้คอมของเราเป็นครัว
สรุปช่วงนี้: Local AI ไม่ได้เป็น AI คนละแบบ แค่ย้ายครัวจากร้านมาไว้ที่บ้านของเรา
ก่อนใช้ออฟไลน์: ต้องดาวน์โหลดแอป โมเดล และส่วนประกอบที่จำเป็นให้ครบก่อนครับ และถ้าต้องการให้ข้อมูลอยู่ในเครื่อง ต้องเลือกโมเดล Local พร้อมตรวจเครื่องมือเสริม การค้นเว็บ และการเชื่อมต่อบริการภายนอกด้วย
ศัพท์ที่ต้องรู้ก่อนเปิดแอป
Training กับ Inference
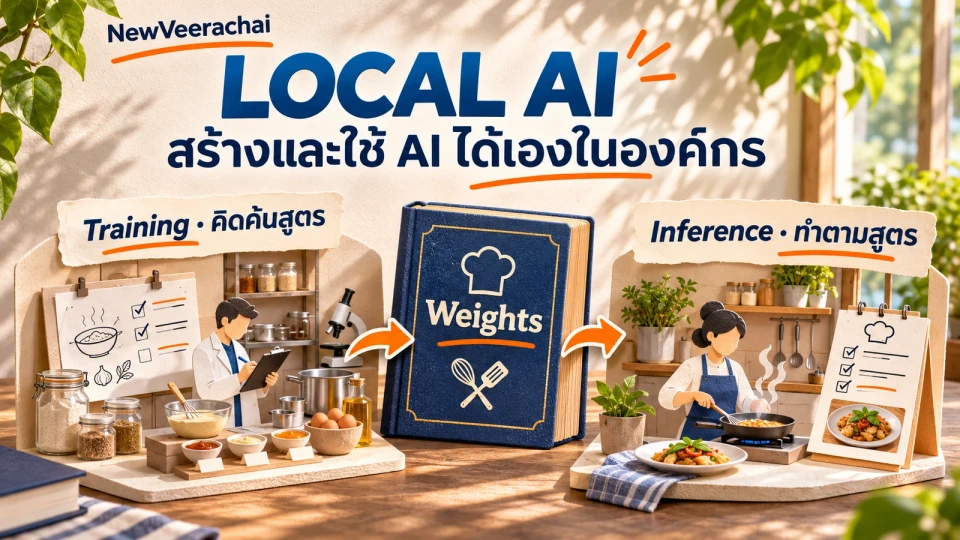
ถ้าเราจะมีครัวที่บ้าน ก็ต้องเข้าใจเรื่องสูตรสักหน่อยครับ สองคำแรกที่จะได้ยินบ่อยคือ Training กับ Inference
Training คือการคิดค้นสูตร บริษัท AI ใช้คอมพิวเตอร์เป็นหมื่น ๆ เครื่อง ลองผิดลองถูกอยู่หลายเดือน กว่าจะได้สูตรที่ใช้ได้ งานนี้เราไม่ต้องทำเอง
Inference คือการทำอาหารตามสูตรที่ได้มาแล้ว ทุกครั้งที่เราพิมพ์ถาม AI นั่นแหละคือ Inference และงานนี้แหละที่คอมที่บ้านทำได้
Weights และโมเดลแบบ Open Weight
ตัวสูตรหรือชุดความรู้ของ AI เรียกว่า Weights ครับ สูตรของ AI ไม่ได้เขียนเป็นตัวหนังสือ แต่เป็นตัวเลขหลายพันล้านตัว ที่ถูกปรับจนลงตัวระหว่าง Training เหมือนสัดส่วนเครื่องปรุงที่ชิมแล้วปรับ ชิมแล้วปรับ จนรสชาติออกมาพอดี
บริษัทไหนยอมให้เราโหลดสูตรไปใช้เอง เรียกว่าโมเดลแบบ Open Weight ส่วนตัวท็อปของ ChatGPT หรือ Claude ยังเก็บสูตรไว้ที่บริษัท โหลดมาใช้เองไม่ได้ โมเดลที่ใช้ในบทความนี้เป็นแบบที่เปิดให้ดาวน์โหลด Weights มารันเองได้ โดยต้องตรวจเงื่อนไขสิทธิ์ใช้งานของแต่ละรุ่นด้วยครับ
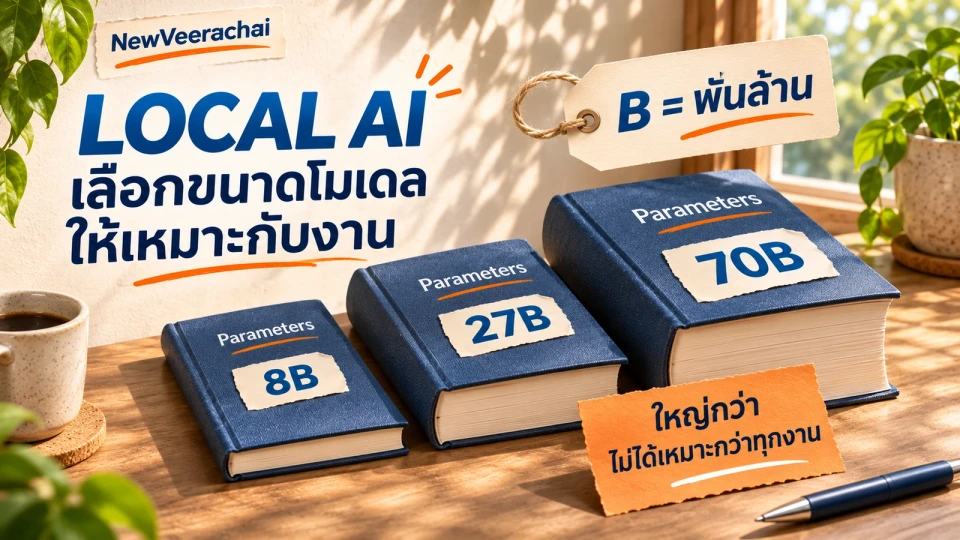
Parameters: ตัวเลขที่ตามด้วยตัว B
ในคลิปผมใช้แอปชื่อ LM Studio Bionic จากทีม LM Studio ตัวนี้ไม่ได้ทำได้แค่แชท แต่เป็น Agent หรือผู้ช่วยที่ลงมือทำงานกับไฟล์และโฟลเดอร์ในเครื่องเราได้ด้วย ในแอปมีทั้งโมเดลที่รันในเครื่องและโมเดลบนคลาวด์ให้เลือก ตามหน้าเอกสารของ LM Studio โมเดลที่รันในเครื่องไม่ใช้เครดิต ส่วนเครดิตใช้กับโมเดลบนคลาวด์ (ข้อมูล ณ เดือนพฤศจิกายน 2569)
พอเข้าไปที่เมนู Settings แล้วเลือก Explore จะเจอหน้าที่เหมือนร้านขายสมุดสูตร มีโมเดลให้เลือกเยอะมาก ลองสังเกตชื่อแต่ละตัวครับ จะมีตัวเลขตามด้วยตัว B ห้อยท้าย อย่าง 27B, 31B หรือ 12B
ตัวเลขนี้เรียกว่า Parameters ครับ B ย่อมาจาก Billion แปลว่าพันล้าน 8B ก็คือสมุดสูตรที่จดตัวเลขไว้แปดพันล้านตัว ยิ่งจดไว้เยอะ สูตรก็ยิ่งละเอียด AI ก็มักจะเก่งขึ้น แต่สมุดก็หนาขึ้น และต้องใช้เครื่องที่แรงขึ้นตามไปด้วย
แต่ตัวใหญ่กว่าไม่ได้แปลว่าดีกว่าเสมอนะครับ ตัวเล็กบางตัวถูกฝึกมาเฉพาะทาง อย่างเขียนโค้ดหรือดูรูป ก็ทำงานนั้นได้ดีไม่แพ้ตัวใหญ่
Quantization: Q4 กับ Q8 คืออะไร
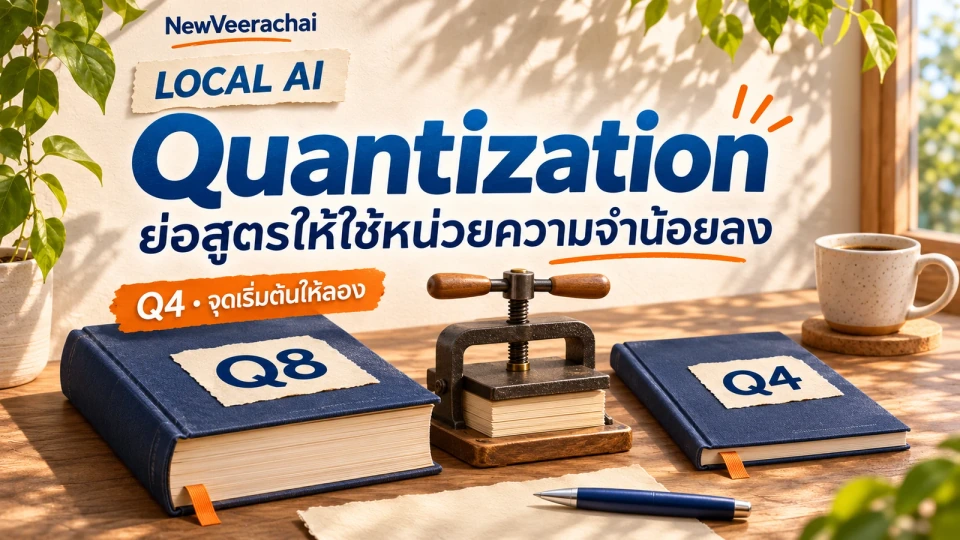
พอกดเข้าไปดูโมเดลตัวหนึ่ง ในตัวเลือกดาวน์โหลดจะเห็นตัว Q ตามด้วยตัวเลข อย่างโมเดลที่ผมใช้ในคลิปเป็น Q4 ขนาดไฟล์ราว 17.7 GB
ตัว Q มาจากคำว่า Quantization คือการย่อสูตรให้บางลง โดยเก็บตัวเลขแต่ละตัวให้ละเอียดน้อยลงนิดนึง Q8 คือเก็บละเอียดแปดบิต Q4 เหลือสี่บิต ไฟล์จึงเล็กลงได้มาก โดยขนาดจริงยังขึ้นกับรูปแบบไฟล์และส่วนประกอบอื่น ๆ ของโมเดล ส่วนคุณภาพคำตอบอาจลดลง จึงควรลองกับงานจริง
เหมือนเราเซฟรูปจากไฟล์ใหญ่ ๆ เป็น JPG ไฟล์เล็กลงเยอะ แต่ตาเรายังแทบไม่เห็นความต่าง สำหรับคนเริ่มต้น Q4 เป็นจุดเริ่มต้นที่น่าลอง แล้วตรวจคุณภาพคำตอบกับงานของเราอีกทีครับ
โดยทั่วไปตัวเลขหลัง Q ยิ่งน้อยก็ยิ่งใช้หน่วยความจำน้อยลง แต่การบีบมากอาจกระทบคุณภาพคำตอบ โดยเฉพาะเมื่อบีบลงไปถึง Q2
แอปบอกได้เลยว่าเครื่องเรารันไหวไหม
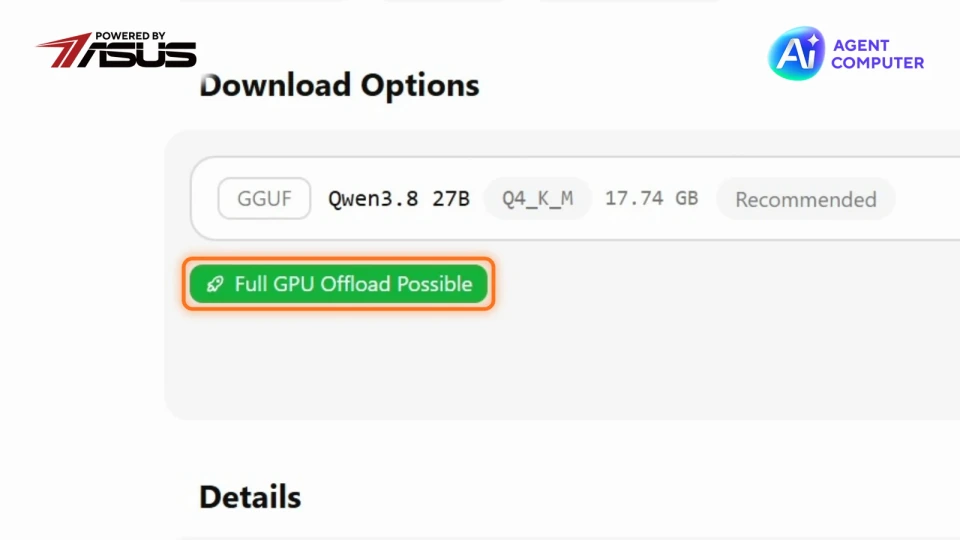
ที่สะดวกมากคือแอปจะติดป้ายบอกเราเลยครับ ว่าเครื่องนี้รันโมเดลตัวไหนไหว
| ป้ายในแอป | ความหมาย | ตัวอย่างในคลิป |
|---|---|---|
| ป้ายเขียว Full GPU Offload Possible | การ์ดจอรับได้ทั้งโมเดล รันได้เต็มที่ | ตัว 27B ที่ Q4 ขนาดราว 17.7 GB |
| Partial GPU Offload Possible | การ์ดจอรับได้แค่บางส่วน | ตัวขนาด 70 กว่า GB |
| Likely too large | แอปเตือนว่าน่าจะใหญ่เกินเครื่อง | ตัวขนาด 100 กว่า GB |
ในคลิปผมเลือก Qwen3.8 27B ที่ Q4 เพราะใหญ่พอจะทำงานแบบ Agent ได้ คือเปิดไฟล์ อ่าน แล้วเขียนไฟล์ใหม่ได้เอง โหลดครั้งเดียวแล้วก็ใช้ได้ตลอดครับ
สรุปช่วงนี้: ตัวเลข B บอกความหนาของสูตร ตัว Q บอกว่าสูตรถูกย่อไปแค่ไหน และป้ายสีในแอปบอกว่าเครื่องเรารับไหวไหม
VRAM: ตัวเลขแรกที่ควรดู
แล้วแอปรู้ได้ยังไงว่าเครื่องรันโมเดลตัวไหนไหว คำตอบอยู่ที่คำที่สำคัญที่สุดในคลิปนี้ครับ คือ VRAM หรือหน่วยความจำบนการ์ดจอ
SSD คือตู้เย็น VRAM คือเขียง
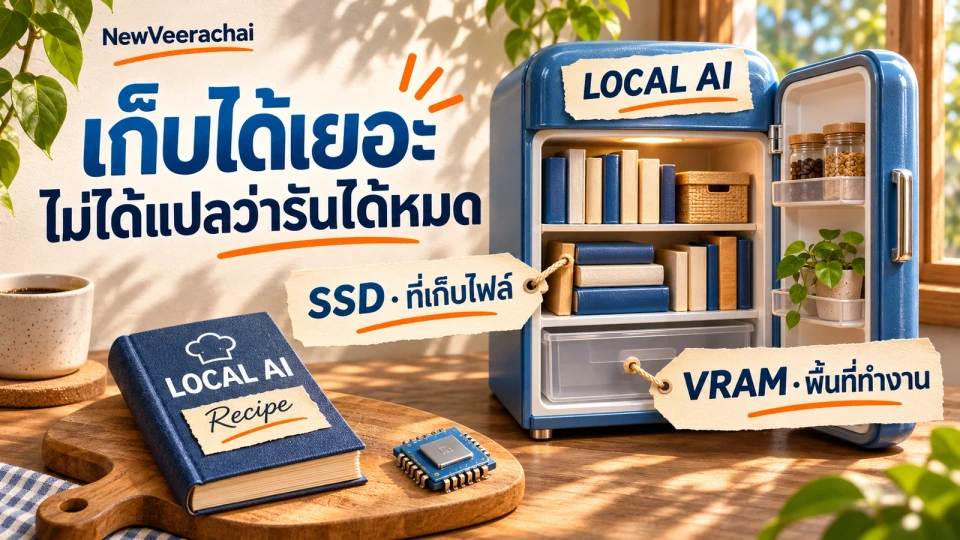
หลายคนอาจคิดว่า SSD ความจุเยอะ ๆ จะโหลดโมเดลใหญ่แค่ไหนก็ได้ โหลดมาเก็บได้จริงครับ แต่ SSD เปรียบเหมือนตู้เย็น มีไว้เก็บของ เก็บได้เยอะก็จริง แต่เราไม่ได้ทำอาหารกันในตู้เย็น
เวลาจะทำอาหาร ของต้องถูกยกออกมาวางบนเขียงก่อน เขียงก็คือพื้นที่ทำงาน จะหั่นจะปรุงอะไร ของต้องวางอยู่บนนั้นให้หมด และเขียงของ AI ก็คือ VRAM นั่นเอง
ถ้าต้องการให้ GPU ทำงานกับโมเดลได้เต็มที่ โมเดลและหน่วยความจำที่ใช้ระหว่างประมวลผลต้องพอดีกับ VRAM ครับ ถ้าโมเดลใหญ่เกิน แอปบางตัวแบ่งบางส่วนไปใช้ RAM และ CPU ได้ เหมือนวางของไว้บนโต๊ะข้างเขียง จึงยังอาจรันได้แต่ความเร็วเปลี่ยนไป ป้าย Partial GPU Offload หมายถึง GPU รับงานของโมเดลได้เพียงบางส่วน ไม่ได้แปลว่าโมเดลจะรันไม่ได้เสมอไป
ลองวางโมเดลลงเขียง 32 GB
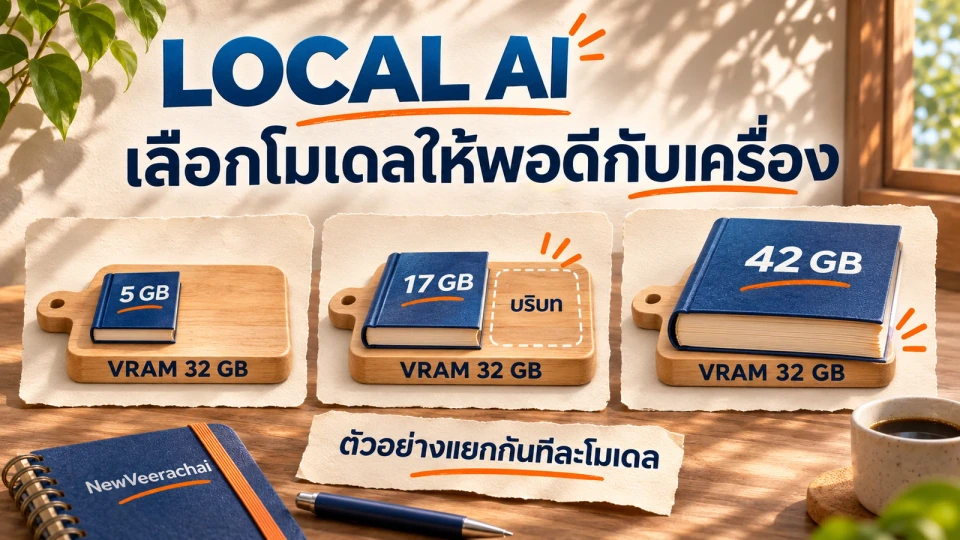
สมมุติเขียงของเรามีขนาด 32 GB เท่ากับการ์ดจอในเครื่องที่ผมใช้ทดสอบ
- โมเดลตัวเล็กขนาดราว 5 GB วางได้สบาย ๆ
- ตัวกลางราว 17 GB ก็ยังพอดี แถมเหลือที่ให้วางบทสนทนากับเอกสารที่เราส่งให้อ่านด้วย
- ตัวใหญ่ราว 42 GB อันนี้ล้นเขียงครับ ต่อให้ SSD เหลือที่อีกเยอะแค่ไหนก็ตาม ส่วนที่ล้นต้องไปพักที่แรม งานจะช้าลงมาก
สังเกตว่าเราต้องเผื่อที่บนเขียงไว้ด้วยนะครับ เพราะนอกจากตัวโมเดลแล้ว ยังมีหน่วยความจำสำหรับบริบทของบทสนทนาและงานประมวลผลอื่น ๆ ด้วย โดยการใช้หน่วยความจำจริงขึ้นกับโปรแกรมและการตั้งค่าครับ
เริ่มจากโมเดลที่พอดี แล้วลองกับงานจริง
สำหรับคนเริ่มต้น ลองโมเดลขนาดกลางที่ Q4 ก่อน แล้วทดสอบกับงานจริงของเราครับ การบีบโมเดลตัวใหญ่ลงไปถึง Q2 อาจกระทบคุณภาพคำตอบ แต่ก็ไม่ได้แปลว่าโมเดลขนาดกลางที่ Q4 จะดีกว่าทุกครั้ง ผลขึ้นกับตัวโมเดล วิธีบีบอัด และงานที่ให้ทำ
เพราะฉะนั้นอย่าเลือกแค่ตัวที่ใหญ่ที่สุด ให้เลือกตัวที่พอดีกับเขียงครับ
เช็กเครื่องตัวเองก่อนโหลดโมเดล
ใครใช้ Windows ดู VRAM ของเครื่องตัวเองได้ง่าย ๆ ครับ เปิด Task Manager ไปที่แท็บ Performance เลือก GPU แล้วดูตัวเลข Dedicated GPU memory นั่นแหละคือขนาดเขียงของเรา
ส่วนตารางว่า VRAM แต่ละขนาด ตั้งแต่ 8 GB ไปจนถึง 32 GB เหมาะกับโมเดลแบบไหน ผมทำไว้ในคู่มือ Local AI 101 ท้ายบทความนี้ครับ
สรุปช่วงนี้: สำหรับพีซีที่ใช้การ์ดจอแยกแบบในคลิป เริ่มจากดู VRAM แล้วดู RAM, CPU และโปรแกรมที่รองรับประกอบด้วย ส่วน Mac และเครื่องที่ใช้หน่วยความจำร่วม ต้องดูหน่วยความจำรวมของเครื่องแทนการเทียบ VRAM อย่างเดียว
เครื่องที่ใช้ทดสอบ: ASUS Agent Computer
เดโม 1: ให้ AI อ่านเอกสารทั้งโฟลเดอร์ แบบไม่ต่อเน็ต
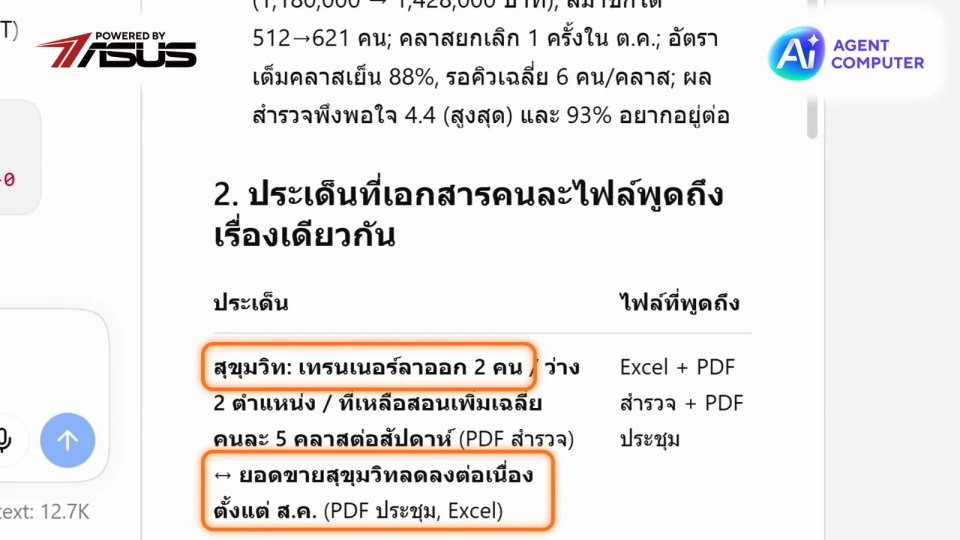
เริ่มจากงานที่คนทำงานน่าจะได้ใช้มากที่สุดก่อนครับ ผมปิด Wi-Fi ถอดสาย LAN ออก มุมจอขึ้นว่าเครื่องไม่ได้ต่ออินเทอร์เน็ตแล้ว
โจทย์ (สถานการณ์จำลอง)
สมมุติว่าผมเป็นพี่เก่ง ผู้จัดการฝ่ายปฏิบัติการของ ABC Wellness บริษัทสมมุติของช่องเรา ทำธุรกิจฟิตเนสและดูแลสุขภาพ มี 3 สาขา คือสุขุมวิท ทองหล่อ และเชียงใหม่
ทุกเดือนพี่เก่งต้องสรุปภาพรวมให้ผู้บริหารก่อนเข้าประชุม เอกสารที่ใช้มียอดขายของ 3 สาขา ผลสำรวจความเห็นพนักงาน และบันทึกการประชุมผู้บริหาร ซึ่งเป็นข้อมูลภายในที่ไม่อยากส่งขึ้นคลาวด์เลย
ผมสร้างโปรเจกต์ใหม่ใน Bionic ตั้งชื่อว่า ABC Wellness แล้วชี้ไปที่โฟลเดอร์เอกสาร จากนั้นเขียนคำสั่งแบบเดียวกับที่เราสั่งผู้ช่วยจริง ๆ ครับ มี 3 ส่วน
- อยากได้อะไร: สรุปเป็นบรีฟ 1 หน้า
- ใครเป็นคนอ่าน: ผู้บริหาร
- เก็บผลไว้ที่ไหน: บันทึกเป็นไฟล์ในโฟลเดอร์เดียวกัน
อ่านทุกไฟล์ในโฟลเดอร์นี้ แล้วสรุปเป็นบรีฟ 1 หน้าสำหรับผู้บริหาร
- แต่ละสาขาเป็นยังไงบ้าง (ใช้ตัวเลขจากไฟล์เท่านั้น ห้ามเดา)
- มีเรื่องไหนที่เอกสารคนละไฟล์พูดถึงเรื่องเดียวกัน
- 3 เรื่องที่ต้องตัดสินใจในเดือนหน้า
บันทึกเป็นไฟล์ Brief_ผู้บริหาร.md ในโฟลเดอร์เดียวกัน
เวลาเอาไปใช้กับงานตัวเอง เปลี่ยนคำว่า "สาขา" เป็นหน่วยงานหรือโปรเจกต์ของเรา และเปลี่ยนชื่อไฟล์ที่จะบันทึกได้เลยครับ
สิ่งที่ได้กลับมา
พอกดส่ง Agent เริ่มอ่านเอกสารในโฟลเดอร์เอง โดยที่เราไม่ต้องแนบไฟล์เข้าไปในแชทเลยสักไฟล์ ในโฟลเดอร์มีทั้งไฟล์ PDF และไฟล์ Excel นี่แหละครับความต่างระหว่าง AI ที่แค่ตอบคำถาม กับ Agent ที่ลงมือทำ
แอปขึ้นว่าใช้เวลา 34 วินาที (วัดจากเครื่องนี้ วันที่ถ่ายทำ) แล้วบรีฟก็ออกมา
- เชียงใหม่ยอดโตต่อเนื่องทุกเดือน
- ทองหล่อคลาสเย็นมีคนจองถึง 97% จนมีคนรอคิว
- สุขุมวิทยอดลดลงต่อเนื่อง
ส่วนที่ผมชอบที่สุดคือ AI เอายอดขายที่ลดลงของสุขุมวิท ไปโยงกับผลสำรวจความเห็นพนักงาน ที่พูดถึงเทรนเนอร์ของสาขานี้ลาออกไป 2 คน ซึ่งสองเรื่องนี้อยู่คนละไฟล์กันเลย
ทั้งที่ในบันทึกการประชุม ผู้บริหารมองว่าเป็นเพราะคู่แข่งเปิดใหม่ และกำลังพิจารณาโปรลดราคา 15% ซึ่งยังไม่อนุมัติ และบรีฟก็ยกเรื่องนี้ขึ้นเป็นเรื่องแรกที่ต้องตัดสินใจ ถ้าไม่มีใครเอาเอกสารมาวางคู่กัน ก็อาจแก้ปัญหาผิดจุดได้ครับ
แล้วบรีฟก็ถูกบันทึกลงในโฟลเดอร์ให้เรียบร้อย ทั้งหมดนี้ทำในเครื่องของเราเอง ตอนที่ไม่มีอินเทอร์เน็ตเลย
สั่งงานต่อได้ทันที
จากบรีฟเดิม ผมสั่งต่อให้ร่างอีเมลนัดคุยกับผู้จัดการสาขาสุขุมวิทครับ
จากบรีฟนี้ ร่างอีเมลถึงผู้จัดการสาขาสุขุมวิท
ขอนัดคุยเรื่องแผนรับเทรนเนอร์เพิ่มภายในสัปดาห์หน้า
สุภาพ กระชับ ไม่เกิน 8 บรรทัด
ได้ร่างอีเมลที่เอาไปแก้ต่อได้เลย แถมหยิบตัวเลขจากบรีฟมาใส่ให้ด้วยว่าเทรนเนอร์เหลือ 6 คนจาก 8 คน แต่ร่างที่ได้ยังต้องอ่านทวนก่อนส่งนะครับ อย่างในคลิป ร่างอีเมลยาวเกิน 8 บรรทัดที่สั่งไว้ และวันที่ของสัปดาห์หน้าก็ต้องเช็กให้ตรงกับปฏิทินจริง
สรุปเดโมนี้: Agent ในเครื่องอ่านเอกสารคนละไฟล์แล้วโยงให้เห็นต้นเหตุที่คนอาจมองข้ามได้ โดยไม่ต้องส่งข้อมูลภายในออกไปไหน
เดโม 2: เจนภาพและคลิปสั้นด้วย ComfyUI
งานเอกสารแบบเมื่อกี้ ไม่จำเป็นต้องใช้เครื่องแรงเท่านี้ครับ ถ้าเลือกโมเดลที่เล็กลงให้พอดีกับ VRAM ของเรา เครื่องขนาดกลาง ๆ ก็ใช้งานได้ (ส่วนตัว 27B ในคลิป ไฟล์ราว 17.7 GB ต้องใช้การ์ดจอที่ VRAM ใหญ่กว่านั้นและเหลือที่ให้เอกสาร) แต่ถ้าอยากดูว่าเขียง 32 GB ทำอะไรได้แค่ไหน ต้องลองกับงานที่หนักกว่านั้น คือการเจนภาพและเจนวิดีโอ
ComfyUI คือสายพานในครัว
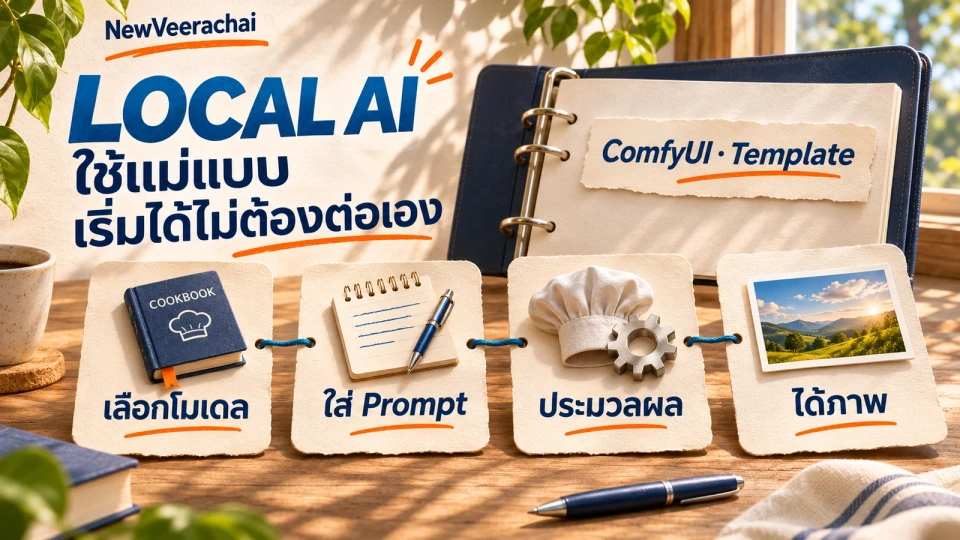
โปรแกรมที่สายนี้นิยมใช้กันคือ ComfyUI ครับ หน้าตาเป็นกล่องต่อสายกันเป็นทอด ๆ เหมือนสายพานในครัว แต่ละกล่องคือขั้นตอนหนึ่งของสูตร ข้อดีคือเราปรับได้ทุกขั้น เลยเป็นตัวที่มืออาชีพชอบใช้
แต่ไม่ต้องกลัวนะครับ เราไม่ต้องต่อเองตั้งแต่ศูนย์ เพราะมีแม่แบบสำเร็จรูป (Template) ให้เลือก ส่วนวิธีติดตั้งที่มีหลายขั้นกว่าแอปทั่วไปหน่อย ผมเขียนไว้ในคู่มือทีละขั้น พร้อมจุดสังเกตว่าแต่ละขั้นต้องเห็นอะไรบนจอ
เจนภาพสตูดิโอโยคะ
ผมกด Templates แล้วเลือกแม่แบบสร้างภาพชื่อ Z-Image-Turbo จากนั้นพิมพ์คำสั่งลงในช่อง Prompt ขอเป็นภาพสตูดิโอโยคะที่เชียงใหม่ตอนพระอาทิตย์ขึ้น แล้วกด Run
A bright modern yoga studio in Chiang Mai at sunrise, large windows overlooking green mountains, warm wooden floor, yoga mats neatly arranged, soft golden morning light, calm atmosphere, photorealistic, wide angleคำแปลโดยสรุป: สตูดิโอโยคะสว่างทันสมัยที่เชียงใหม่ตอนพระอาทิตย์ขึ้น หน้าต่างบานใหญ่มองเห็นภูเขาสีเขียว พื้นไม้โทนอุ่น เสื่อโยคะวางเรียงเป็นระเบียบ แสงเช้าสีทองนุ่ม ๆ บรรยากาศสงบ เหมือนภาพถ่ายจริง มุมกว้าง
ภาพนี้ใช้เวลาเจนไม่ถึง 3 วินาที (วัดจากเครื่องนี้ วันที่ถ่ายทำ) และทำในเครื่องล้วน ๆ จะเจนอีกสิบภาพ ร้อยภาพ ก็ไม่มีค่าใช้จ่ายต่อภาพครับ
ให้ภาพขยับเป็นคลิปสั้น
ต่อมาผมเลือกแม่แบบที่แปลงภาพเป็นวิดีโอ (ในคลิปใช้แม่แบบ Wan 2.2 14B Image to Video) ใส่ภาพเมื่อกี้เข้าไป แล้วบอกว่าอยากให้กล้องค่อย ๆ เคลื่อนไปหาหน้าต่าง
Slow camera push-in toward the windows, morning light slowly brightening, curtains gently moving in the breeze, calm and peacefulคำแปลโดยสรุป: กล้องค่อย ๆ เคลื่อนเข้าหาหน้าต่าง แสงเช้าค่อย ๆ สว่างขึ้น ผ้าม่านพลิ้วเบา ๆ ตามลม บรรยากาศสงบ
งานวิดีโอใช้เวลานานกว่าภาพพอสมควรครับ วิดีโอยาว 5 วินาทีในคลิปใช้เวลาเจนราว 2 นาที 20 วินาที (วัดจากเครื่องนี้ วันที่ถ่ายทำ) ระหว่างรอผมเปิด Task Manager ให้ดู การ์ดจอทำงานเกือบ 100% และใช้ VRAM ไปราว 24 GB จาก 32 GB
เหตุผลก็เพราะวิดีโอคือภาพนิ่งจำนวนมากที่ต้องเชื่อมต่อกันให้ไหลลื่น งานแบบนี้เลยต้องใช้เขียงหรือการ์ดจอขนาดใหญ่ครับ
สรุปเดโมนี้: งานเอกสารใช้เครื่องขนาดกลางได้ถ้าเลือกโมเดลให้พอดีกับเครื่อง แต่งานเจนวิดีโอใช้ VRAM เยอะ ถ้าอยากทำงานสายนี้จริงจัง ขนาด VRAM ยิ่งสำคัญ
AI PowerSuite ของ ASUS: รวมทุกอย่างไว้ในหน้าเดียว
จากที่ทดสอบมา จะเห็นว่าผมใช้ 2 โปรแกรม ตัวแรกสำหรับแชทและงานเอกสาร อีกตัวสำหรับเจนภาพและวิดีโอ
ASUS กำลังเตรียมโปรแกรมชื่อ AI PowerSuite ที่จะมากับเครื่องในอนาคต (ยังไม่ประกาศว่าจะมากับรุ่นไหนและเมื่อไหร่) ผมได้ลองเวอร์ชันทดลอง ตัวนี้รวมทุกอย่างไว้ในหน้าเดียว เมนูทั้งหมดอยู่ทางซ้ายมือ
- คลังโมเดล: มีตัวที่แนะนำให้กดโหลดได้เลย หรือเพิ่มโมเดลจากข้างนอกเองก็ได้
- แชต: ถามงาน ให้ช่วยคิด ช่วยเขียน
- สร้างภาพ: พิมพ์บอกเป็นภาษาไทยได้เลยว่าอยากได้ภาพแบบไหน
- สร้างวิดีโอ: ทำคลิปสั้นได้ในโปรแกรมเดียวกัน ไม่ต้องสลับไปมาหลายโปรแกรม
ถ้าตัวจริงออกมาเหมือนที่ผมได้ลอง จุดที่ผมมองว่าน่าสนใจคือคนที่ซื้อเครื่องไป จะมีที่ให้เริ่มใช้งาน AI ได้เลย ไม่ต้องลงโปรแกรมเพิ่มหรือตั้งค่าเองเยอะ ส่วนหน้าตาและเมนูอาจเปลี่ยนได้เมื่อออกตัวจริงครับ
สรุปช่วงนี้: ใครอยากเริ่ม Local AI ในโปรแกรมเดียว AI PowerSuite น่าติดตาม แต่ตอนนี้ยังเป็นเวอร์ชันทดลอง
ใครควรใช้ Local ใครควรใช้คลาวด์
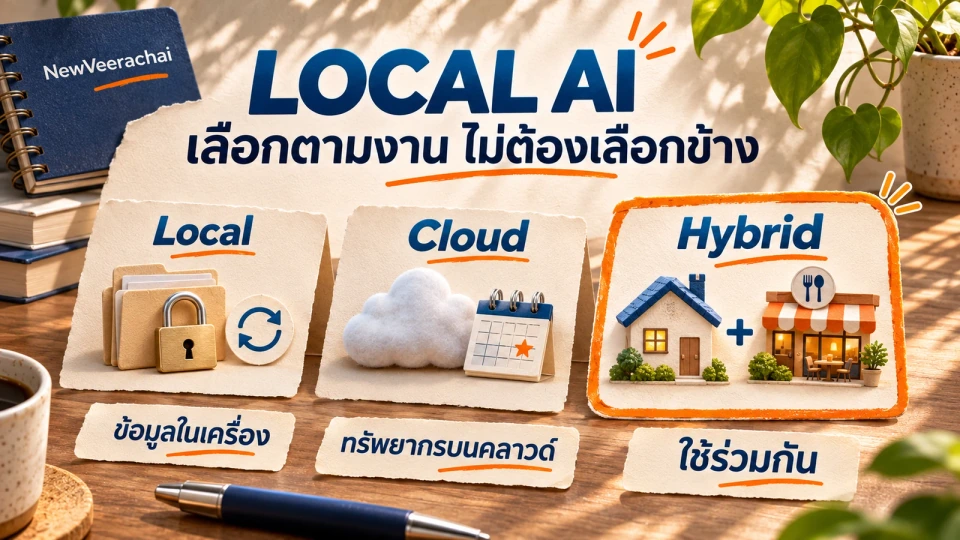
คำถามที่หลายคนน่าจะสงสัยคือ งั้นเราควรย้ายมาใช้ Local AI ทั้งหมดเลยไหม
คำตอบของผมคือไม่จำเป็นครับ ใครที่ใช้ Claude, ChatGPT หรือ Gemini อยู่แล้วก็ยังใช้ต่อได้ เพราะโมเดลบนคลาวด์เก่งเรื่องการคิดวิเคราะห์ข้อมูลที่ซับซ้อนมาก ๆ และช่วยค้นข้อมูลล่าสุดบนอินเทอร์เน็ตได้ดี
แต่สำหรับคนที่ต้องการความปลอดภัยและความเป็นส่วนตัว โดยเฉพาะคนที่ใช้งานในบริษัทหรือองค์กร Local AI ตอบโจทย์ตรงนี้ได้ดี เพราะข้อมูลไม่ต้องออกจากเครื่อง
| แบบไหน | คุ้มเมื่อ | เพราะอะไร |
|---|---|---|
| Local AI | งานใช้ข้อมูลที่ไม่อยากให้ออกจากบริษัท ทำซ้ำทุกวันในปริมาณเยอะ หรือต้องทำในที่ที่เน็ตไม่ดี | ข้อมูลอยู่ในเครื่อง ไม่มีค่าใช้จ่ายต่อครั้ง และไม่ต้องพึ่งอินเทอร์เน็ต |
| คลาวด์ | ใช้ AI นาน ๆ ครั้ง หรืออยากได้ตัวที่เก่งที่สุดอยู่เสมอ | ไม่ต้องลงทุนเครื่อง และได้โมเดลรุ่นใหม่ก่อน |
| Hybrid | ใช้ทั้งสองแบบตามงาน | ทำกับข้าวกินเองทุกวัน แล้วสั่งร้านในวันที่อยากได้เมนูพิเศษ |
เช็กว่างานของเราเหมาะกับ Local ไหม
ถ้าติ๊กได้หลายข้อ งานนั้นน่าลองย้ายมาทำแบบ Local ครับ ส่วนงานที่เหลือใช้คลาวด์ต่อไปได้
สรุปช่วงนี้: สำหรับหลายคน คำตอบที่ดีที่สุดคือ Hybrid เลือกที่ทำงานให้ตรงกับงาน ไม่ต้องเลือกข้างใดข้างหนึ่ง
ศัพท์ Local AI 6 คำ สรุปในภาพเดียว
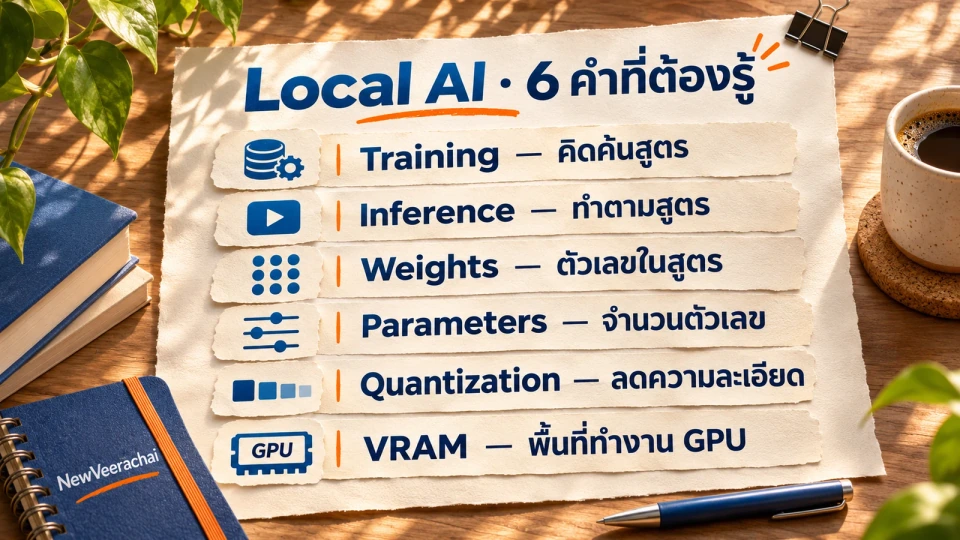
จำศัพท์ชุดนี้ได้ เปิดแอป Local AI ตัวไหนขึ้นมาก็อ่านหน้าจอเข้าใจแล้วครับ
ข้อควรรู้ก่อนใช้จริง 3 เรื่อง
- ถ้าอยากให้ข้อมูลอยู่ในเครื่อง ต้องเลือกโมเดลที่รันในเครื่อง แอปบางตัว รวมถึง LM Studio Bionic มีทั้งโมเดลในเครื่องและโมเดลบนคลาวด์ให้เลือก ตามหน้าเอกสารของ LM Studio โมเดลที่รันในเครื่องไม่ใช้เครดิต ส่วนเครดิตใช้กับโมเดลบนคลาวด์ ถ้างานไหนเป็นข้อมูลลับ ให้เช็กก่อนว่าเลือกโมเดลในเครื่องอยู่ (ข้อมูล ณ เดือนพฤศจิกายน 2569)
- ผลที่ได้ต้องอ่านทวนเสมอ AI ในเครื่องโยงข้อมูลข้ามไฟล์ได้ดี แต่ก็พลาดได้เหมือน AI บนคลาวด์ อย่างร่างอีเมลในเดโมยาวเกินที่สั่ง และวันที่ต้องเช็กเอง ก่อนส่งให้ใครให้ตรวจตัวเลขกับไฟล์ต้นทางก่อน
- ไม่มีค่าใช้จ่ายต่อครั้ง แต่มีต้นทุนที่เครื่อง งานที่รันในเครื่องไม่ต้องจ่ายค่าโทเคนหรือค่าเจนต่อภาพ แต่ความเร็วและขนาดโมเดลที่ใช้ได้ขึ้นกับการ์ดจอของเรา เวลาเจนและตัวเลขในบทความนี้วัดจากเครื่องที่ใช้ทดสอบ วันที่ถ่ายทำ เครื่องอื่นจะได้ตัวเลขต่างไป
สรุป Local AI 101
- Local AI คือการมีครัวที่บ้าน โหลดโมเดลแบบ Open Weight มาไว้ในเครื่อง แล้วใช้คอมเราเป็นที่ประมวลผล
- ตัวเลขที่ต้องดูคือ VRAM ไม่ใช่ขนาด SSD เลือกโมเดลที่ขนาดพอดีกับเขียง และเหลือที่ให้บทสนทนากับเอกสาร
- เริ่มที่ Q4 และตัวขนาดกลาง แล้วเทียบคุณภาพกับความเร็วจากงานจริงของเรา
- Agent ในเครื่องทำงานเอกสารได้จริง อ่านทั้งโฟลเดอร์ โยงข้อมูลข้ามไฟล์ แล้วบันทึกผลเป็นไฟล์ได้โดยไม่ต่อเน็ต
- ไม่ต้องย้ายมาทั้งหมด ใช้แบบ Hybrid ตามงาน งานลับหรืองานซ้ำทำในเครื่อง งานที่ต้องการตัวเก่งที่สุดใช้คลาวด์
รับคู่มือ Local AI 101 ฟรี
คำถามที่พบบ่อย
Local AI คืออะไร ต่างจาก ChatGPT ยังไง?
Local AI คือการโหลดโมเดล AI มาทำงานบนคอมของเราเอง แทนการส่งคำถามไปประมวลผลที่ศูนย์ข้อมูลของบริษัท AI ผ่านอินเทอร์เน็ต ข้อมูลที่ใช้เลยอยู่ในเครื่อง และใช้ได้แม้ไม่ต่อเน็ต ส่วน ChatGPT เป็น AI บนคลาวด์ ซึ่งตัวท็อปของ ChatGPT โหลดมาใช้ในเครื่องไม่ได้
คอมต้องแรงแค่ไหนถึงจะรัน Local AI ได้?
สำหรับพีซีที่มีการ์ดจอแยก ให้เริ่มดูจาก VRAM แล้วดู RAM, CPU และโปรแกรมที่รองรับประกอบด้วยครับ โมเดลที่ลง GPU ได้ทั้งหมดมักทำงานได้คล่องกว่า แต่บางโปรแกรมแบ่งงานไปใช้ RAM และ CPU ได้ งานเอกสารเริ่มจากโมเดลเล็กได้ ส่วนงานวิดีโอต้องเผื่อหน่วยความจำมากขึ้น สำหรับ Mac หรือเครื่องแบบหน่วยความจำร่วม ให้ดูหน่วยความจำรวมแทนการเทียบ VRAM อย่างเดียว
SSD ใหญ่ ๆ ช่วยให้รันโมเดลใหญ่ได้ไหม?
SSD ช่วยเก็บไฟล์โมเดลได้มากขึ้นครับ แต่ความสามารถในการรันยังขึ้นกับหน่วยความจำและกำลังประมวลผล โมเดลที่ใหญ่กว่า VRAM อาจแบ่งงานไปใช้ RAM และ CPU ได้ถ้าโปรแกรมรองรับ แต่ความเร็วอาจลดลง จึงต้องดูทั้งระบบ ไม่ใช่ SSD อย่างเดียว
Q4 กับ Q8 ควรเลือกแบบไหน?
Q8 เก็บตัวเลขละเอียดกว่าและใช้หน่วยความจำมากกว่า ส่วน Q4 ลดความละเอียดลงเพื่อให้ไฟล์เล็กลงครับ เริ่มจาก Q4 แล้วลองกับงานจริงได้ แต่คุณภาพขึ้นกับรุ่นโมเดล วิธีบีบอัด และงานที่ทำ ไม่ควรสรุปว่าตัวกลาง Q4 ดีกว่าตัวใหญ่ Q2 ทุกกรณี
ใช้ Local AI แล้วข้อมูลจะไม่ถูกส่งออกไปข้างนอกใช่ไหม?
การเลือกโมเดล Local ทำให้การอนุมานเกิดบนเครื่องครับ แต่ต้องดูด้วยว่าแอปเปิดการค้นเว็บ เครื่องมือเสริม หรือบริการภายนอกไว้หรือไม่ ในเดโมปิด Wi-Fi และถอด LAN หลังเตรียมแอปกับโมเดลครบแล้ว ส่วนงานข้อมูลลับควรใช้ระบบและบัญชีที่องค์กรอนุญาต
ต้องย้ายจาก AI บนคลาวด์มาใช้ Local ทั้งหมดไหม?
ไม่จำเป็นครับ โมเดลบนคลาวด์ยังเก่งเรื่องการวิเคราะห์ที่ซับซ้อนและการค้นข้อมูลล่าสุด หลายคนเหมาะกับแบบ Hybrid คือใช้ Local กับงานข้อมูลลับหรืองานซ้ำทุกวัน แล้วใช้คลาวด์กับงานที่ต้องการตัวเก่งที่สุด